The Nature Conservancy Fisheries Monitoring
這是我之前參加的一個Kaggle舉辦的比賽,為期大概四五個月,但實際上我參加時間不到一個月,來筆記下我學到的東西。
Problem Statement,簡單來說就是有六類魚,一個other類,再一個No fish的種類一共有八類
- Albacore Tuna
- Bigeye Tuna
- Dolphinfish
- Moonfish
- Shark
- Yellowfin Tuna
- Others
- No Fish
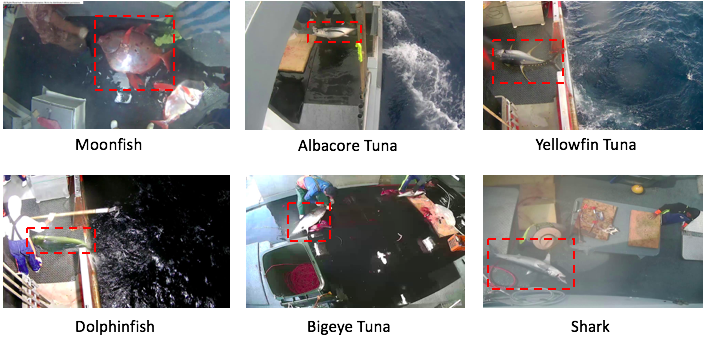
很多人以為這應該是一個分類問題,但實際上它是一個object detection的問題,因為魚相對於背景的占比差異實在大,背景過大造成無法有效的判斷出分類。
這個比賽看似簡單,其實是一個困難的問題,原因如下:
- 要用少量資料(<3000)去預測大量資料(>1w)。
- 類分布相當不平均,ALB的魚種幾乎占了全部的1/2。
- 這似乎是用camera連續攝影的截圖,有很多張是一樣的圖片,很容易造成overfitting。
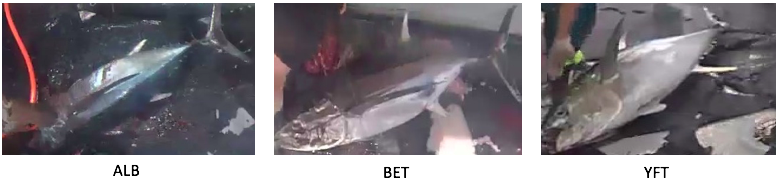
- 下面這個種魚實在太像,連肉眼都很難分辨。
以下為當時我採用的方法:
- Faster RCNN => 採用了此物體偵測方法,Paper
- Data augmentation (only HUE) =>只做了HUE的data augmentation,由於照片裡面會有晚上夜釣的情形,所以會有透過夜視鏡所呈現的照片(night fish)
- Clips (0.04 and 0.96) => 由於評分標準是採用 log loss:
 我們求出來的機率分布範圍是0~1,在極值的情況(0.0001)會產生很大的懲罰,所以clips 0.02~0.98是一個很好的手法。
- Run in 60000 inter, batch size 16
以上都不是重點,重點是由第八名的Felix Fu所撰寫的參賽完整心得分享 (Thanks again):
我們缺少了:
- 強化的Data augmentation
- 更深的classification model
- Model ensemble (因為是offline 所以盡情用吧)
- Establishing a GOOD Local Validation (這個意思是Felix發現,我們自己在做local validation的時候,需要用不一樣的船隻做測試,這樣才能避免魚跟船過度關聯,因為同一艘船有可能捕的魚種都比較相同,但如果測試資料集給的是沒出現過的魚種,就會造成很大的影響)


沒有留言:
張貼留言